
Wie die Polizei ihre KI mit unseren Daten trainiert
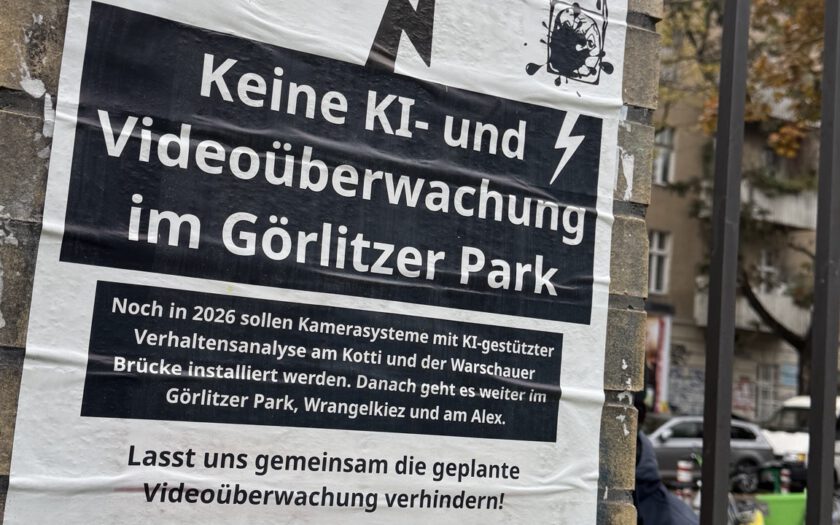
Die Berliner Polizei baut seit September 2026 an sogenannten „kriminalitätsbelasteten Orten (kbO)" ein KI-gestütztes Videoschutzsystem auf. Das Pilotprojekt startet am Kottbusser Tor, anschließend sollen unter anderem die Warschauer Brücke und weitere „kbO“ folgen. Die Software soll Videobilder analysieren und bestimmte Verhaltensmuster wie körperliche Auseinandersetzungen erkennen.
Die Kameras speichern alles
Die Antwort der Senatsverwaltung für Inneres und Sport auf eine Schriftliche Anfrage der Linken (Drucksache 19/26879) zeigt, wie umfassend die Datenerfassung ist. "Die Videorohdaten werden kontinuierlich aufgezeichnet und gespeichert", schreibt die Senatsverwaltung. Die automatische Regellöschung erfolgt grundsätzlich nach einem Monat, sofern die Aufnahmen nicht etwa zur Verfolgung von Straftaten benötigt werden.
Gespeichert werden damit nicht nur die Bilder von Situationen, die die KI als auffällig erkennt. Erfasst wird das Geschehen im gesamten überwachten Bereich. Alle Menschen, die sich dort aufhalten, können auf den Aufnahmen zu sehen sein.
Aus Videoaufzeichnungen wird Trainingsmaterial
Die Senatsverwaltung erklärt ausdrücklich, dass beim „KI-Videoschutz" reale Test-, Pilot- oder Ereignisdaten für Validierung, Qualitätssicherung und Optimierung beziehungsweise Nachtraining verwendet werden können. Das gebe die Rechtslage her. Die Trainings- und Testdaten würden dabei aus „ausgewählten Aufzeichnungen" gewonnen.
Diese Aufzeichnungen stammen aus dem Bestand der kontinuierlich gespeicherten Videorohdaten. Damit können auch Aufnahmen für Training und Testung verwendet werden, in denen keine von der KI erkannte Gefahrensituation vorkommt. Eine Person muss dafür weder tatverdächtig sein noch ein auffälliges Verhalten gezeigt haben. Es reicht, dass sie auf einer Aufnahme aus dem überwachten Bereich zu sehen ist, die für Training oder Testung ausgewählt wird.
Neben dem Training und Testing dürfen nach § 42d Abs. 3 ASOG „Auftragsverarbeitende und zur Verarbeitung eingesetzte Dritte“ die trainierten Modelle darüber hinaus für eigene Zwecke weiternutzen, „wenn Polizei oder Feuerwehr dem zugestimmt haben und sichergestellt werden kann, dass aus den trainierten Modellen keine Trainingsdaten abgeleitet werden können.“
Verweis auf Anonymisierung überzeugt nicht
Die Senatsverwaltung verweist zur Absicherung auf die Anonymisierung. Für Training und Testung sollen „wirksam bzw. irreversibel anonymisierte" Datenbestände verwendet werden. Eine Reidentifizierung natürlicher Personen soll ausgeschlossen werden.
Gleichzeitig räumt die Senatsverwaltung ein, dass die Anonymisierung auch entfallen kann. So dürfen nach § 42d Abs. 2 ASOG auch personenbezogene Daten für das Training und die Testung von KI-Systemen weiterverarbeitet werden, wenn Anonymisierung bzw. Pseudonymisierung dem Zweck der Testung oder des Trainings entgegensteht oder mit unverhältnismäßigem Aufwand verbunden sei. § 42d Abs. 3 ASOG erlaubt zudem die Weitergabe personenbezogener Daten an Dritte, wenn die Verarbeitung durch Polizei oder Feuerwehr selbst nicht oder nur mit „unverhältnismäßigem Aufwand“ möglich wäre.
Auch praktisch ist eine Anonymisierung solcher Daten nur schwer umsetzbar. Ein System, das menschliches Verhalten anhand von Videobildern erkennen soll, braucht Informationen über genau dieses Verhalten. Bewegungen, Körperhaltung, räumliche Beziehungen, zeitliche Abläufe und andere visuelle Merkmale können für das Training relevant sein. Je stärker diese Informationen anonymisiert werden, desto fraglicher wird ihre Verwendbarkeit für das Training.
Die Senatsverwaltung kann deshalb nicht zugleich auf eine irreversible Anonymisierung verweisen und offenlassen, ob genau diese Anonymisierung für den Trainingszweck aufgegeben werden muss. Offen bleibt demnach, welche Informationen tatsächlich entfernt werden und welche erhalten bleiben, damit die KI aus den Aufnahmen überhaupt lernen kann.
Die KI lernt aus einer vorselektierten Welt
42d Abs. 1 ASOG schreibt vor, dass diskriminierende Algorithmen bei Training und Testung weder herausgebildet noch verwendet werden dürfen. Bei einer probabilistischen KI lässt sich daraus allerdings keine technische Garantie ableiten. Ein solches System lernt statistische Zusammenhänge aus seinen Trainingsdaten. Sind bestimmte Personen, Verhaltensweisen oder Situationen darin überrepräsentiert, können sich diese Muster im Modell niederschlagen.
Wo stärker kontrolliert und überwacht wird, werden mehr Verstöße festgestellt und bestimmte Gruppen oder Verhaltensweisen entsprechend häufiger in den polizeilichen Daten sichtbar. Werden solche Videodaten anschließend für das Training verwendet, sind Stigmatisierungen im wahrsten Sinne des Wortes vorprogrammiert.
Problematisch ist deshalb auch, woher die Trainingsdaten stammen. Sie werden nicht in einer neutralen Stichprobe des Berliner Stadtgebiets erhoben, sondern unter anderem an sogenannten „kriminalitätsbelasteten Orten“ (kbO).
„Kriminalitätsbelastet“ bedeutet dabei nicht, dass dort die meisten Straftaten registriert werden. Die Einstufung als „kbO“ wird mit der unterschiedlichen Art von Kriminalität begründet, wie etwa im Fall der Rigaer Straße mit einer Häufung von politisch motivierter Straftaten. Welche Delikte wie gewichtet werden, ist dabei für die Öffentlichkeit nur eingeschränkt nachvollziehbar.
Die „kbO“ bilden damit keine neutrale Auswahl besonders krimineller Orte ab. Stattdessen liegt der Verdacht nahe, es handele sich bei der Auswahl um eine politische Entscheidung.
Wenn Überwachung zur Trainingsdatenbank wird
Das Berliner KI-Videoschutzsystem erfasst das Geschehen im gesamten überwachten Bereich. Aus den Aufnahmen können Daten für Training, Testung und Nachtraining des Systems entstehen, auch wenn die abgebildeten Personen keinen Anlass für eine polizeiliche Maßnahme gegeben haben.
Für das Training sollen die Daten grundsätzlich anonymisiert werden. Gleichzeitig erlaubt § 42d ASOG unter bestimmten Voraussetzungen die Verarbeitung personenbezogener Daten, wenn eine Anonymisierung dem Trainingszweck entgegensteht oder mit unverhältnismäßigem Aufwand verbunden wäre. Auch eine Verarbeitung durch Dritte ist möglich.
Hinzu kommt die Herkunft der Trainingsdaten. Nach welchen Kriterien die sogenannten „kbO“ eingestuft und einzelne Kriminalitätsphänomene gewichtet werden, ist nur eingeschränkt nachvollziehbar. Wo stärker kontrolliert wird, entstehen auch mehr polizeiliche Daten. Werden diese für das KI-Training genutzt, können sich die Schwerpunkte der polizeilichen Überwachung in den statistischen Mustern des Systems wiederfinden. Die polizeiliche Auswahl prägt damit die Daten, aus denen die KI lernt, und kann beeinflussen, was sie später als auffällig erkennt.
Die Risiken sind systemimmanent
Das Berliner KI-Videoschutzsystem ist nicht nur ein weiteres Überwachungsinstrument, sondern ein System, das sich aus seinen eigenen Daten speist und damit in einen sich selbst verstärkenden Kreislauf gerät. Was die KI lernt, beeinflusst, was sie künftig als auffällig einstuft und damit wiederum, wo und wie überwacht wird. Die Auswahl der „kriminalitätsbelasteten Orte" als Trainingsgrundlage macht diesen Kreislauf besonders problematisch, weil sie eine politische Entscheidung als technische Gegebenheit tarnt. Der Verweis auf Anonymisierung und Diskriminierungsverbote ändert daran wenig, solange die Rechtslage gleichzeitig erlaubt, personenbezogene Daten zu verarbeiten, wenn die Anonymisierung „mit unverhältnismäßigem Aufwand" verbunden wäre. Am Ende bleibt die Frage, wer entscheidet, was die KI lernen soll und ob die Antwort darauf nicht bereits in der Auswahl der Kamerastandorte festgeschrieben ist.
Weiterführende Quellen
- Schriftliche Anfrage im AGH: https://pardok.parlament-berlin.de/starweb/adis/citat/VT/19/SchrAnfr/S19-26879.pdf
- Medienbericht bei netzpolitik.org: https://netzpolitik.org/2026/ki-training-berliner-verhaltensscanner-sollen-privatfirmen-mit-echtdaten-fuettern/
- Medienbericht bei B.Z.: https://www.bz-berlin.de/berlin/ueberwachung-berliner-werden-unfreiwillig-trainingsmaterial-fuer-ki-6aaab059bfb40073cb2f3e66
- Pressemitteilung zum Start von „KI-gestütztem Videoschutz“: https://www.berlin.de/polizei/polizeimeldungen/2026/pressemitteilung.1718008.php
- Übersichtsseite zu KI-gestützten „Videoschutzsystemen“ an kriminalitätsbelasteten Orten (kbO) in Berlin: https://www.berlin.de/polizei/polizeimeldungen/fakten-hintergruende/artikel.1694896.php
- Gesetzestext zu § 42d ASOG Bln (Training und Testung von KI-Systemen): https://gesetze.berlin.de/bsbe/document/jlr-NNLBE00004772NN00000000200
Beitragsfoto von Alena Jakobs